我一直想学习如何使用Docker的新沙箱功能部署一个AI RAG代理。文档主要覆盖了“编码”代理——如Claude Code、Codex等。没有“如何将你自己的代理想法打包成一个沙箱”的介绍。
所以我做了我总是做的事情。
工作流程
步骤1:获取想法。 我有一个想法:在Docker沙箱中部署一个RAG代理。
步骤2:深入研究。 我启动了12个不同的聊天机器人,并从不同角度问了他们同一个问题。沙箱架构是什么?隔离层是什么?凭证代理是如何工作的?网络模型是什么?
步骤3:输入深度研究代理。 所有这些回答都被编译成一份综合报告。
步骤4:发布。 这份报告成为一篇博客文章。现在我有了一个可以实际使用的参考资料。
步骤5:阅读自己的报告。 我知道Docker沙箱能做什么。现在我需要弄清楚如何让它做我想要的事情。
步骤6:输入编码代理。 我将沙箱文档、我想要的技术栈(Pydantic AI、Qdrant、RustFS、Langfuse、Ollama)以及我想要构建的代理类型输入给编码代理。不是“帮我找一个教程”。而是“这里是你需要的上下文,构建这个。”
步骤7:迭代。 几轮编码、审查、修复。
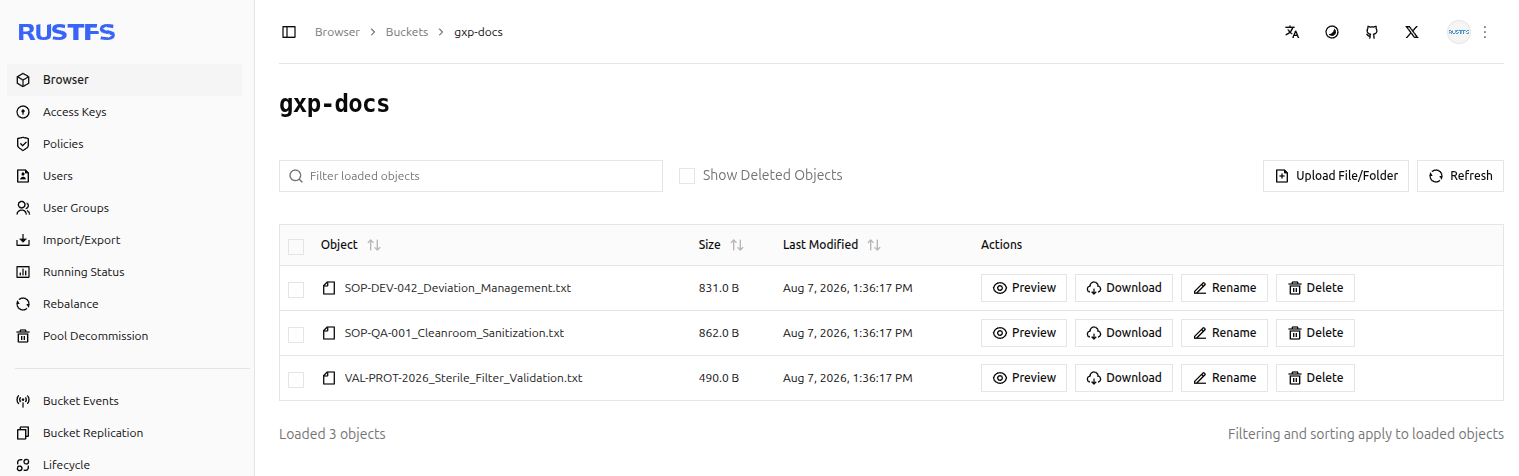
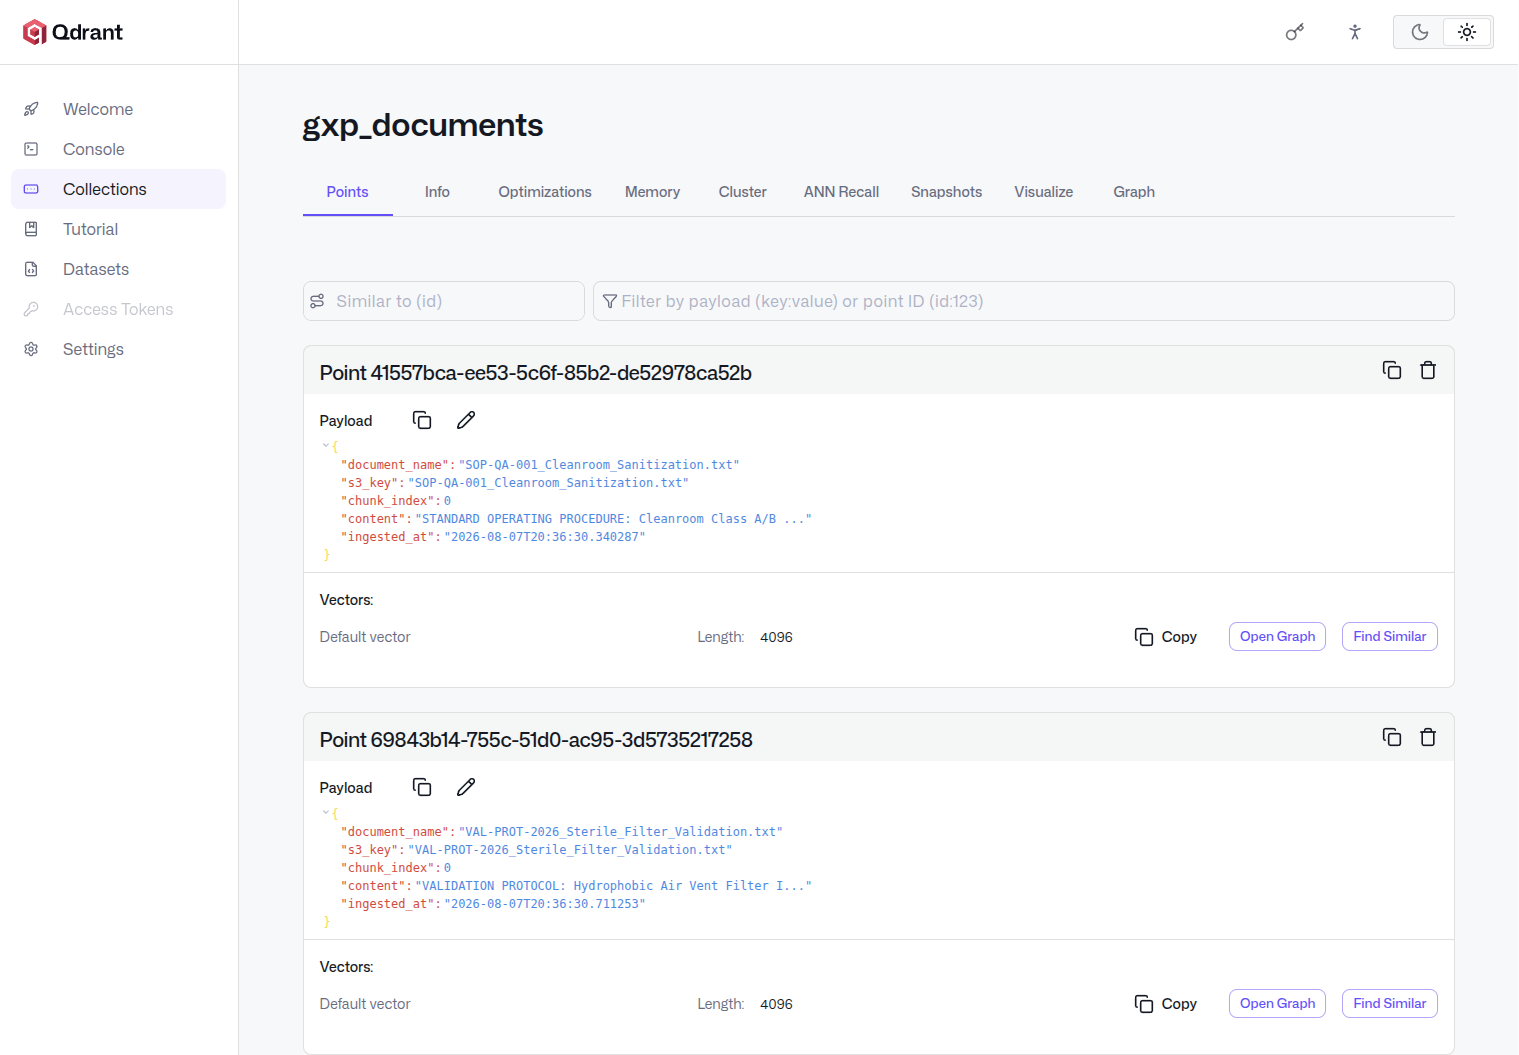
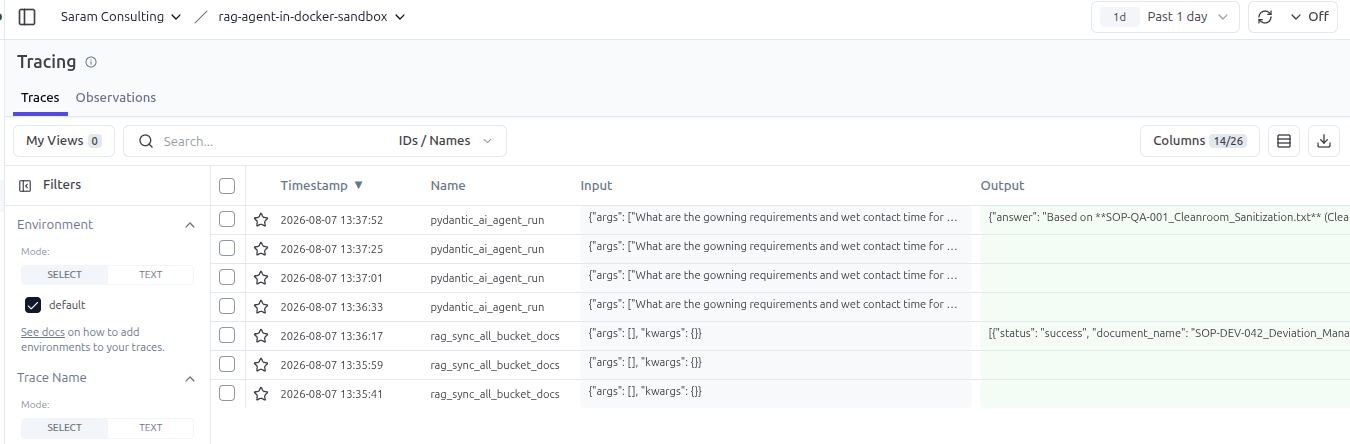
结果:一个Docker沙箱中的RAG代理,该代理从S3存储中摄取GxP SOPs,使用本地模型生成嵌入,将它们矢量化到Qdrant,并通过Pydantic AI代理回答合规性问题。所有内容都容器化并隔离。
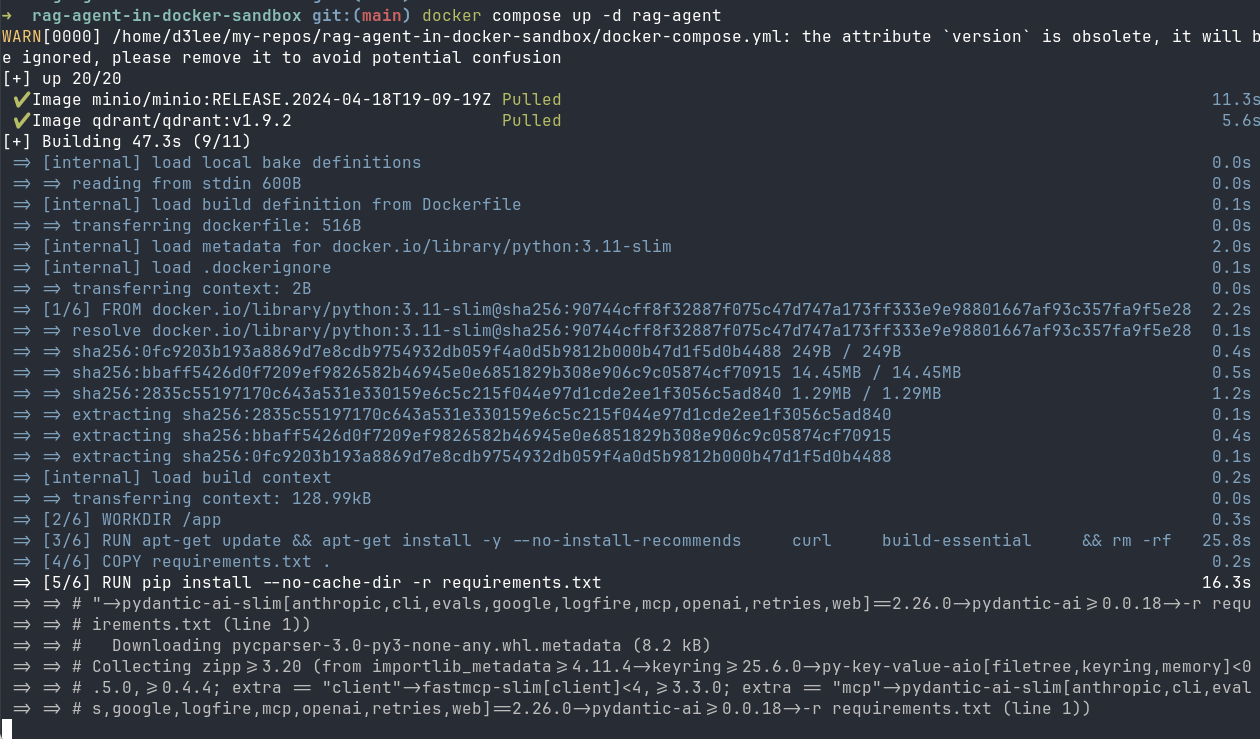
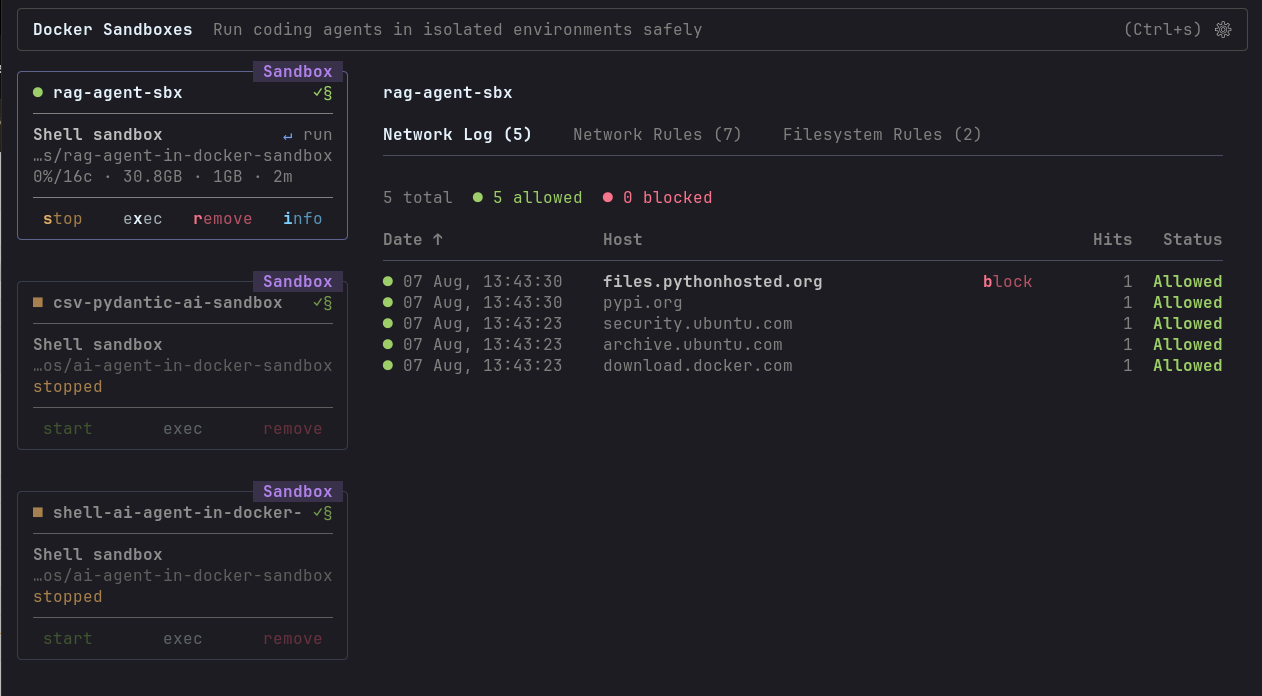
以下是该堆栈的实际运行情况:
没有通用的教程
我不再需要寻找匹配我具体设置的教程。没有“在Docker沙箱中运行带有Qdrant和RustFS的Pydantic AI RAG代理”的教程。这样的教程不存在,也永远不会存在。
但我的编码代理可以生成符合我具体需求的代码示例。我将文档、约束条件以及我想要的架构提供给它——它会构建出来。GitHub仓库中包含了完整的运行代码:Dockerfile、docker-compose、API端点、向量摄取脚本等。
一些想法
AI是一种工具。像使用工具一样使用它。 如果你认为“AI现在在做有趣的部分(编码),而我被卡在了无聊的部分(检查错误、测试)”,你将会遇到麻烦。重新定义它:你的新工具完成了80%的工作。利用你释放出来的时间来改进剩下的20%。这才是真正的杠杆。
并非每个人都能做到这一点。 我观察编码代理生成代码,以及我需要检查或验证的事项数量——这是一项艰巨的任务。我不确定没有编程经验的人能否做到这一点。知道何时代理出错需要领域知识。聪明的孩子可能会搞明白,但没有手写编码经验就开始使用AI是一个真正的差距。
AI是缩小差距还是扩大差距? Sean Goedecke有一篇很棒的文章,“LLMs奖励专业知识”,分析了Terence Tao与ChatGPT关于雅各布猜想的对话。关键在于:Tao的提示简短,他反驳模糊的答案,模型以“与数学家对话”的模式回应——而不是“向业余爱好者解释”的模式。你不能仅仅通过遵循提示来复制他的提示技巧。关键是真正理解数学。
同样的道理也适用于代码。我可以告诉编码代理“这看起来过于复杂,简化一下”因为我知道在我的技术栈中什么是干净的解决方案。如果没有这种直觉,你就会被模型生成的内容所支配。你拥有的领域知识越多,就越能引导。Goedecke说得很好:瓶颈是人,而不是模型。
差距不是对AI的访问。每个人都有访问。差距在于知道问什么问题以及何时答案是错误的。