Docker의 새로운 샌드박스 기능을 활용해 AI RAG 에이전트를 배포하는 방법을 배우고 싶었다. 공식 문서는 대부분 Claude Code나 Codex 같은 전형적인 ‘코딩’ 에이전트에 집중되어 있었다. “자신만의 에이전트 아이디어를 샌드박스에 패키징하는 법” 같은 가이드는 없었다.
그래서 나는 언제나 하던 방식을 따랐다.
나의 워크플로
1단계: 아이디어 구상. 내게는 “Docker 샌드박스 안에서 RAG 에이전트를 실행해 보겠다”는 아이디어가 있었다.
2단계: 심층 리서치. 12개의 서로 다른 챗봇을 띄워놓고 다양한 각도에서 동일한 질문을 던졌다. 샌드박스의 아키텍처는 무엇인가? 격리 계층은 어떻게 구성되는가? 자격 증명 프록시는 어떻게 동작하는가? 네트워크 모델은 어떠한가?
3단계: 딥 리서치 에이전트에 주입. 수집된 모든 답변을 종합 분석 에이전트에 넣어 포괄적인 단일 보고서로 취합했다.
4단계: 글 게시. 이 취합된 보고서를 바탕으로 블로그 글을 작성했다. 이제 언제든 참고할 수 있는 훌륭한 레퍼런스가 생겼다.
5단계: 내가 쓴 보고서 정독. Docker Sandboxes가 무엇을 할 수 있는지 완벽히 파악했다. 이제 이를 바탕으로 내가 원하는 작업을 어떻게 수행시킬지 구체화한다.
6단계: 코딩 에이전트에 투입. 내가 구축하려는 기술 스택(Pydantic AI, Qdrant, RustFS, Langfuse, Ollama), 샌드박스 관련 공식 문서, 그리고 만들고자 하는 에이전트의 명세를 코딩 에이전트에 넘겨주었다. “튜토리얼 좀 찾아줘” 같은 요청은 하지 않는다. “여기 맥락이 있으니, 이것을 만들어라”고 지시할 뿐이다.
7단계: 반복 개선. 몇 차례의 코드 작성, 코드 리뷰, 버그 수정을 거쳤다.
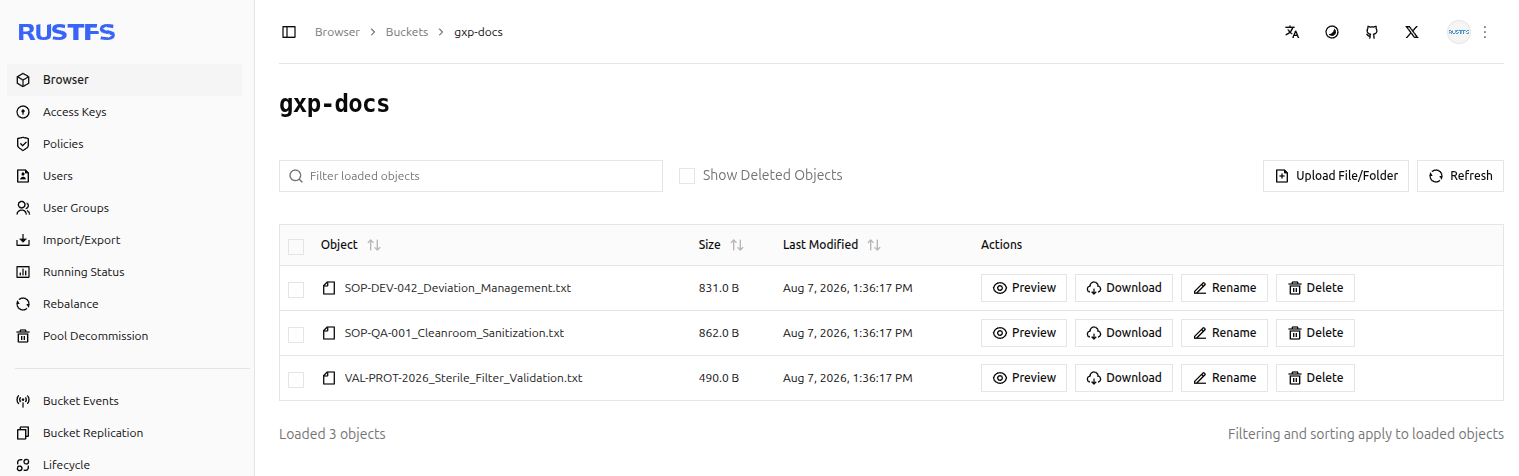
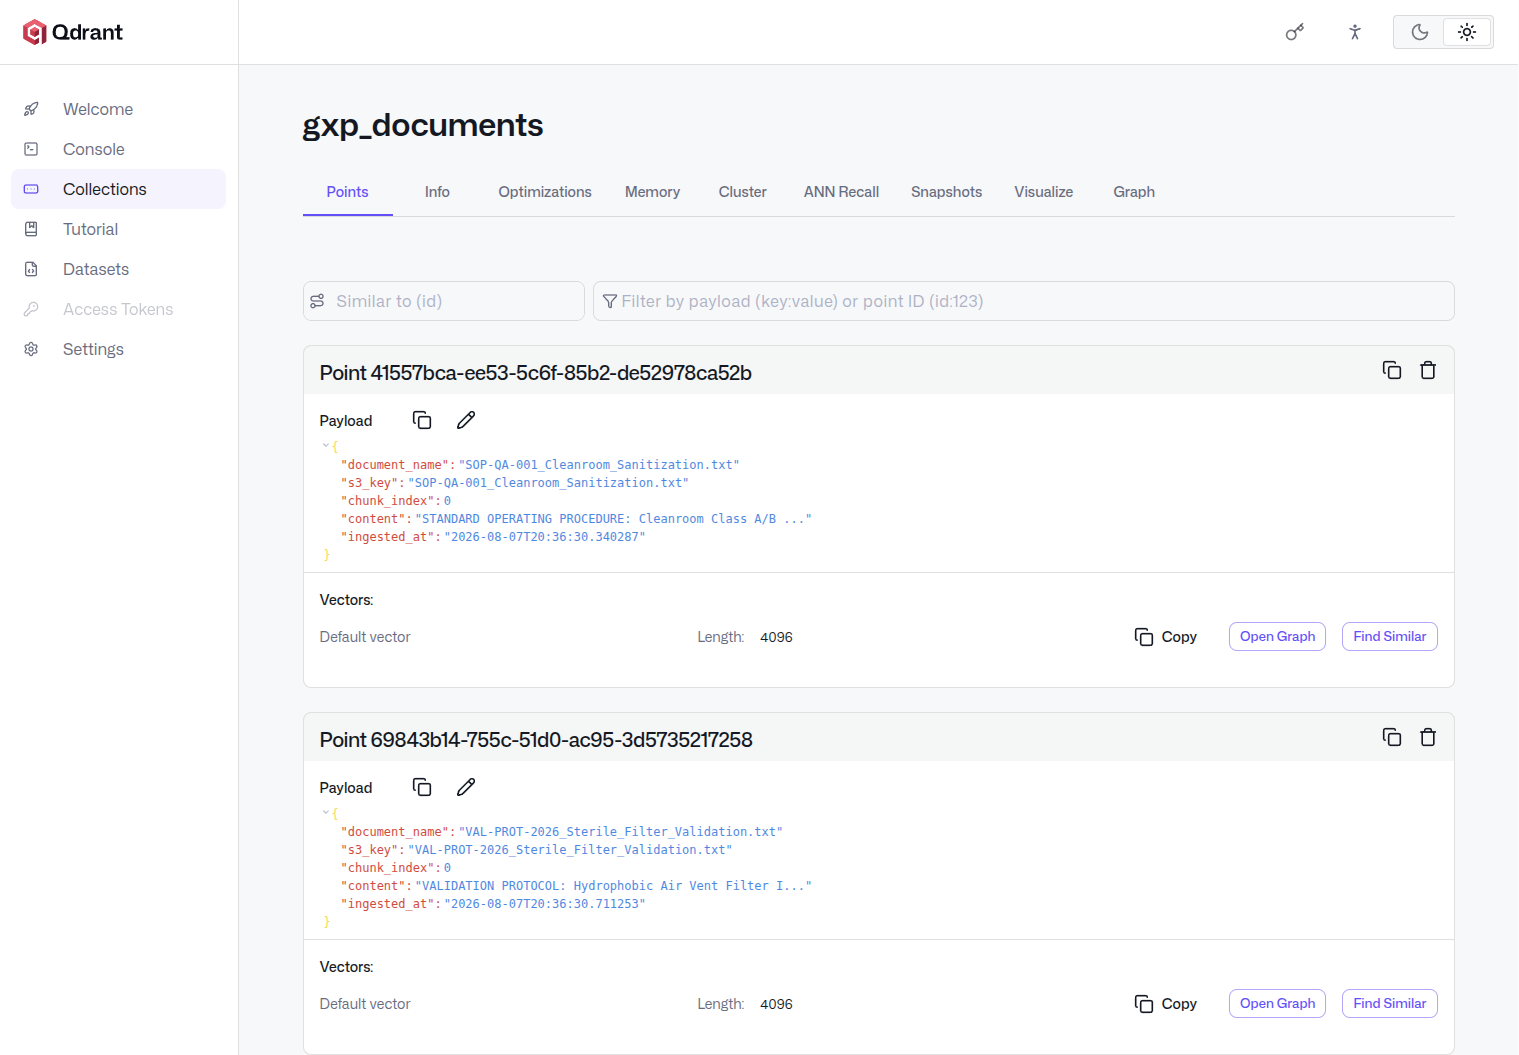
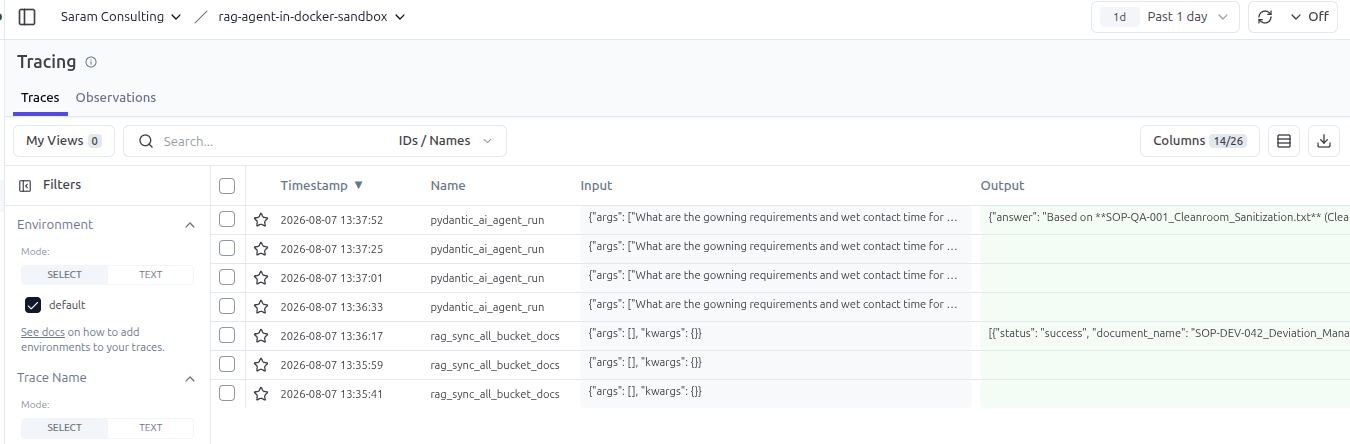
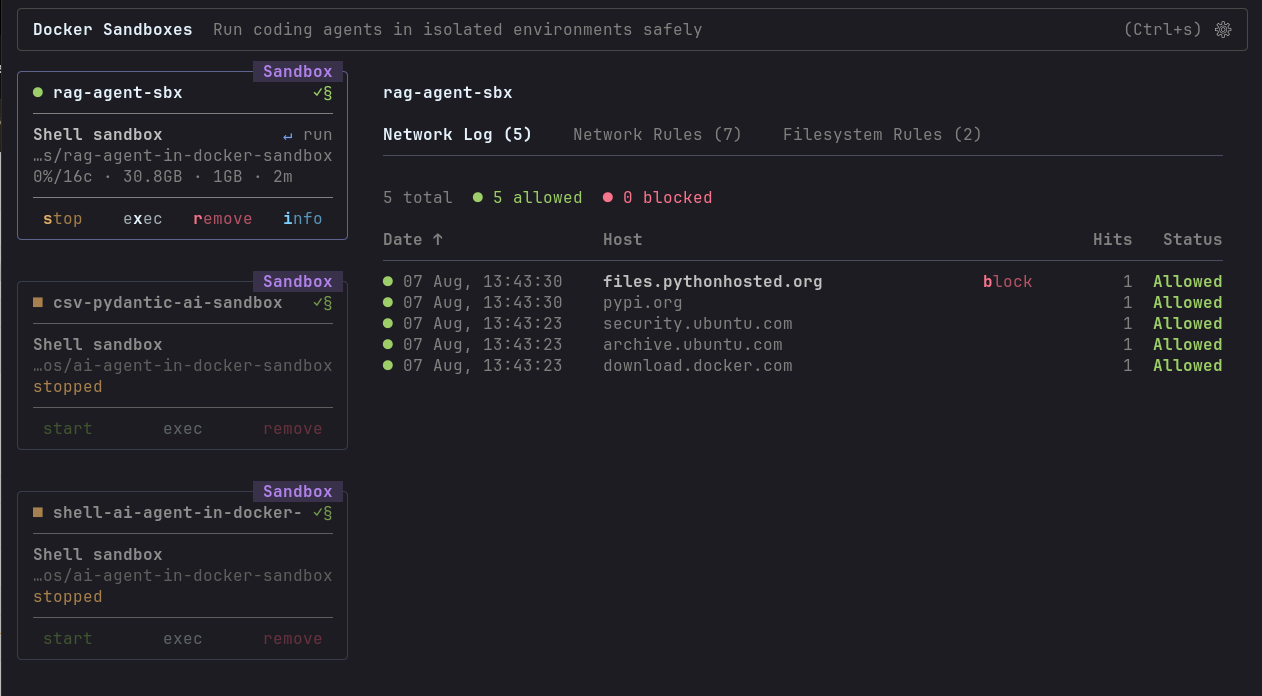
그 결과물로 Docker 샌드박스 안에서 동작하는 RAG 에이전트가 완성되었다. S3 저장소에서 GxP SOP 문서를 수집하고, 로컬 모델로 임베딩을 생성하여 Qdrant에 벡터화한 뒤, Pydantic AI 에이전트를 통해 규제 준수 관련 질문에 답하는 시스템이다. 모든 것이 컨테이너화되었고, 완벽히 격리되었다.
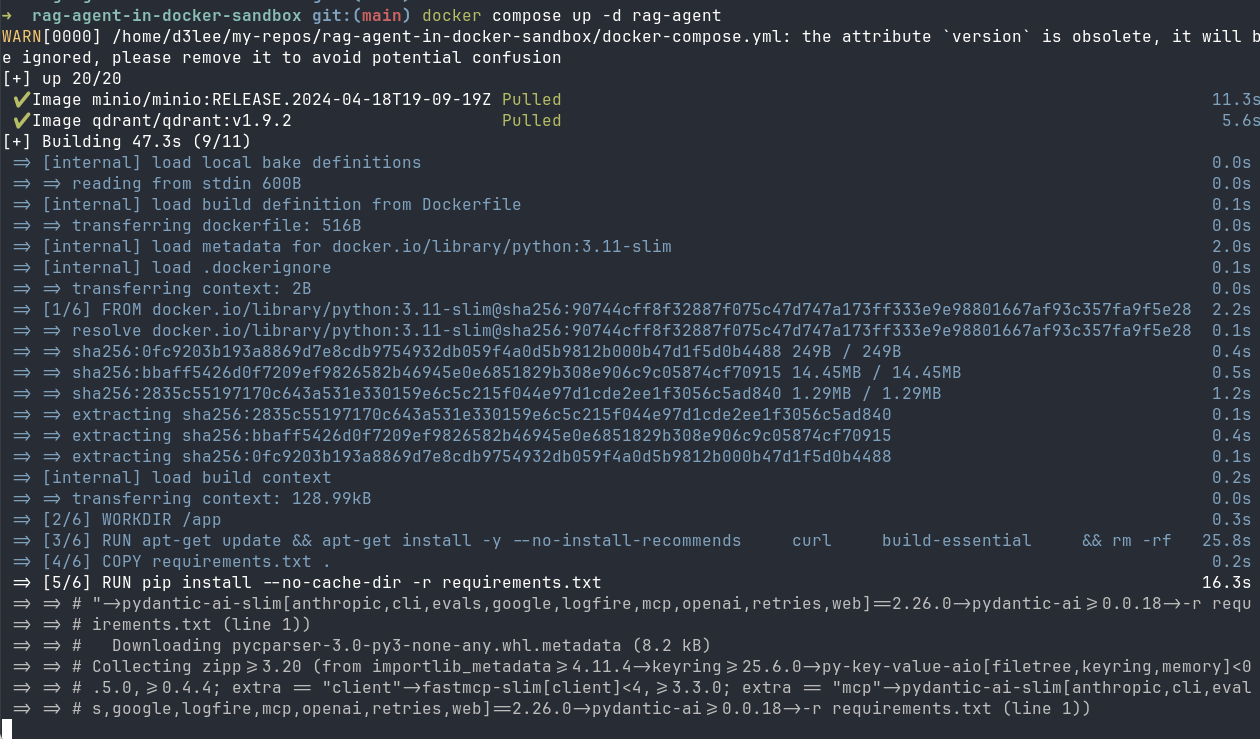
실제 구동 중인 스택의 모습이다:
기성 튜토리얼은 이제 필요 없다
더 이상 내 정확한 환경에 들어맞는 튜토리얼을 찾아 헤맬 필요가 없다. “Langfuse 관측 가능성을 갖추고 Docker 샌드박스 내에서 Qdrant와 RustFS를 연동한 Pydantic AI RAG 에이전트 만들기” 같은 튜토리얼은 세상에 존재하지 않는다. 앞으로도 영원히 없을 것이다.
하지만 코딩 에이전트는 내 정확한 요구사항에 맞춘 완벽한 코드 예제를 즉석에서 만들어낼 수 있다. 문서와 제약 조건, 원하는 아키텍처를 제공하기만 하면 에이전트가 이를 구현해 낸다. GitHub 저장소에는 Dockerfile, docker-compose, API 엔드포인트, 벡터 수집 스크립트 등 작동하는 전체 코드가 고스란히 담겨 있다.
몇 가지 생각들
AI는 도구다. 도구답게 써야 한다. 만약 “AI가 재미있는 부분(코딩)을 다 가져가고 나는 지루한 부분(에러 검토, 테스트)만 맡게 되었다”고 생각한다면 일상이 괴로워질 것이다. 프레임을 바꾸어야 한다. 새로운 도구가 작업의 80%를 대신 처리해 주는 것이다. 확보된 시간을 활용해 나머지 20%를 더 정교하게 다듬어야 한다. 진짜 레버리지는 바로 거기서 발생한다.
지금 당장은 누구나 이렇게 할 수 있는 것은 아니다. 코딩 에이전트가 쏟아내는 코드를 보면서 내가 일일이 스팟 체크하고 검증해야 하는 양은 결코 적지 않다. 프로그래밍 경험이 전혀 없는 사람이 지금 당장 이런 방식을 온전히 소화할 수 있을지는 솔직히 의문이다. 에이전트가 언제 엉뚱한 소리를 하는지 알아채려면 도메인 지식이 필수적이다. 영리한 친구들은 빠르게 깨우칠 수도 있겠지만, 손으로 직접 코딩해 본 경험 없이 곧바로 AI로만 개발을 시작하는 것에는 분명한 한계가 존재한다.
AI는 운동장을 평평하게 만드는가, 아니면 격차를 더 벌리는가? Sean Goedecke의 뛰어난 글 “LLM은 전문성을 보상한다(LLMs Reward Expertise)”에서는 테렌스 타오(Terence Tao)가 야코비 추측(Jacobian Conjecture)에 관해 ChatGPT와 나눈 대화를 분석한다. 핵심 통찰은 이것이다. 타오의 프롬프트는 매우 짧으며, 모델의 모호한 답변을 정확하게 반박하고, 그에 따라 모델은 ’비전공자에게 설명하는 모드’가 아니라 ’수학자와 대화하는 모드’로 응답을 전환한다. 단순한 프롬프트 팁을 흉내 낸다고 해서 그의 방식을 따라 할 수는 없다. 본질은 실제로 그 수학을 이해하고 있는가에 달려 있다.
코드에서도 똑같은 일이 일어난다. 내가 코딩 에이전트에게 “이건 너무 오버엔지니어링된 것 같으니 단순화해 달라”고 말할 수 있는 이유는, 내 스택에서 깔끔한 솔루션이 어떤 모습이어야 하는지 이미 알고 있기 때문이다. 그런 직관이 없다면 모델이 뱉어내는 결과물에 휘둘릴 수밖에 없다. 도메인 지식이 깊을수록 AI를 훨씬 더 강력하게 조종할 수 있다. Goedecke의 표현대로, 병목은 모델이 아니라 인간이다.
진짜 격차는 AI 접근성에서 오지 않는다. 접근 권한은 모두에게 열려 있다. 진짜 격차는 무엇을 물어야 할지 아는 것, 그리고 돌아온 답변이 틀렸음을 알아채는 눈에서 갈린다.